分散分析(ANOVA)のやり方2026|一元配置・二元配置とF値・多重比較の読み方
分散分析(ANOVA)とは、3つ以上のグループ間で平均値に統計的に意味のある差があるかどうかを、1回の検定でまとめて検証するための統計的手法である。卒業論文や修士論文で3群以上を比較する場面では、t検定を何度も繰り返すのではなく、分散分析のやり方を正しく理解して使うことが求められる。本記事では一元配置・二元配置の違いから、F値とp値の読み方、帰無仮説の立て方、有意差が出た後の多重比較まで、実際の分析手順に沿って解説する。
分散分析(ANOVA)とは何か?t検定との違いは?
分散分析(Analysis of Variance、ANOVA)は、3つ以上の群の平均値を同時に比較するための検定である。t検定は2群の平均値の差しか検定できないため、3群以上を比較したい場合にt検定を繰り返すと、検定を行うたびに誤って有意差ありと判定してしまう確率(第一種の過誤)が積み上がってしまう。分散分析は全群の平均を一括で検定することで、この過誤の積み重ねを避けられる点がt検定との大きな違いである。t検定の具体的な手順はt検定のやり方で解説しているので、2群比較の場合はそちらを参照してほしい。
一元配置分散分析と二元配置分散分析の違いは?
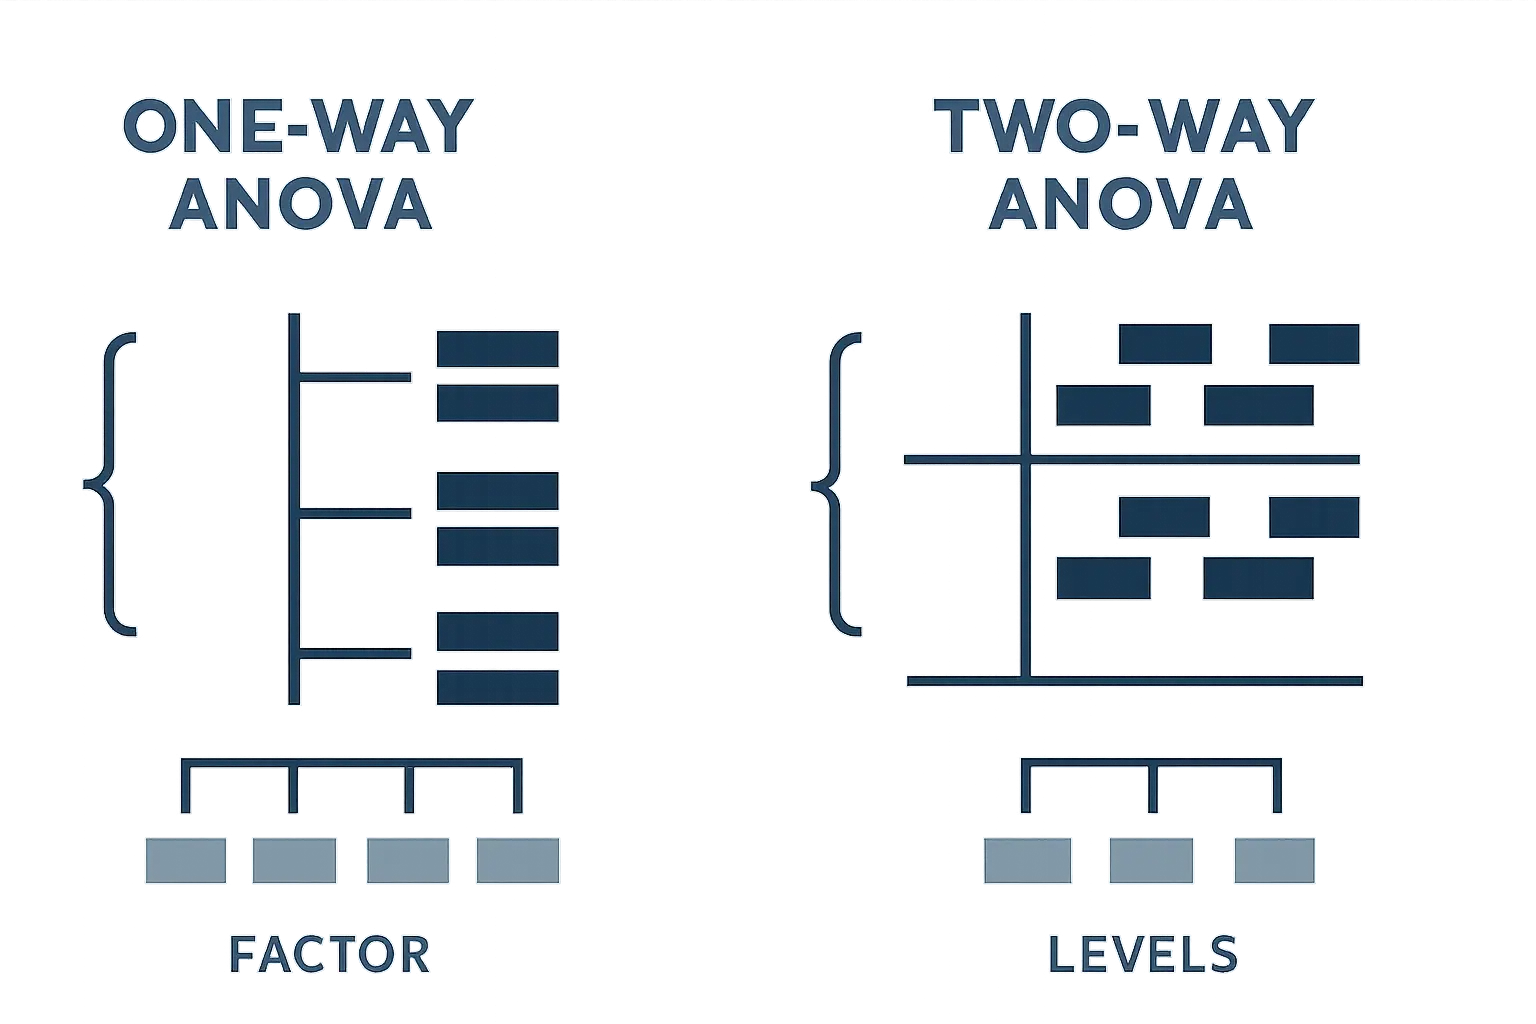
分散分析は、独立変数(要因)の数によって種類が分かれる。
| 種類 | 要因の数 | 典型的な問い | 例(イメージ) |
|---|---|---|---|
| 一元配置分散分析 | 1つ | 1つの要因の水準間で平均値に差があるか | 例:学習方法(A・B・C法)でテスト得点に差があるか |
| 二元配置分散分析 | 2つ | 2つの要因それぞれの主効果と、要因同士の交互作用があるか | 例:学習方法と学年の組み合わせでテスト得点に差があるか |
二元配置分散分析では、各要因が単独で結果に与える影響(主効果)に加えて、2つの要因が組み合わさることで生じる相乗的な効果(交互作用)を確認できる点が特徴である。交互作用が有意な場合、要因を個別に解釈するのではなく、組み合わせごとの傾向をグラフ(交互作用プロット)で確認するのが一般的な進め方になる。
分散分析はどうやって計算する?F値の求め方は?
分散分析のやり方は、大きく次の手順で進む。
- 全データの平均(全体平均)を求める。
- 群間変動(各群の平均が全体平均からどれだけ離れているか)を計算する。
- 群内変動(各群の中でデータが平均からどれだけばらついているか)を計算する。
- 群間変動と群内変動をそれぞれ自由度で割り、平均平方(分散の推定値)を求める。
- 群間の平均平方を群内の平均平方で割り、F値を算出する。
- F分布表またはソフトウェアの出力からp値を確認する。
手計算でこの手順を追うことも可能だが、実際の研究ではSPSS・R・Excel分析ツールなどの統計ソフトを使ってF値とp値を出力させるのが一般的である。どの統計手法を使うべきか迷う場合は、統計手法の選び方フローチャートでデータの種類と目的から絞り込むとよい。
F値とp値はどう読めばよい?
F値は「群間のばらつき」を「群内のばらつき」で割った比率であり、値が大きいほど群間の差が群内のばらつきに比べて相対的に大きいことを示す。ただしF値の大きさだけを見て良し悪しを判断するのではなく、有意水準(多くの研究では0.05)と比較したp値で判断するのが基本である。p値が有意水準を下回れば「群間に差がない」という帰無仮説を棄却し、「少なくとも1組の群間に統計的に有意な差がある」と結論づけられる。逆にp値が有意水準を上回った場合は、群間に差があるとは言えない、という結論にとどめる必要がある。
帰無仮説と対立仮説はどう立てる?
分散分析における帰無仮説(H0)は「すべての群の母平均は等しい」であり、対立仮説(H1)は「少なくとも1組の群間で母平均が異なる」である。ここで注意したいのは、対立仮説は「すべての群が互いに異なる」という意味ではなく、「どこか1組にでも差があれば成立する」という点である。そのため分散分析で有意差が確認できても、その時点ではどの群とどの群の間に差があるのかまでは分からない。
有意差が出たらどうする?多重比較とは?
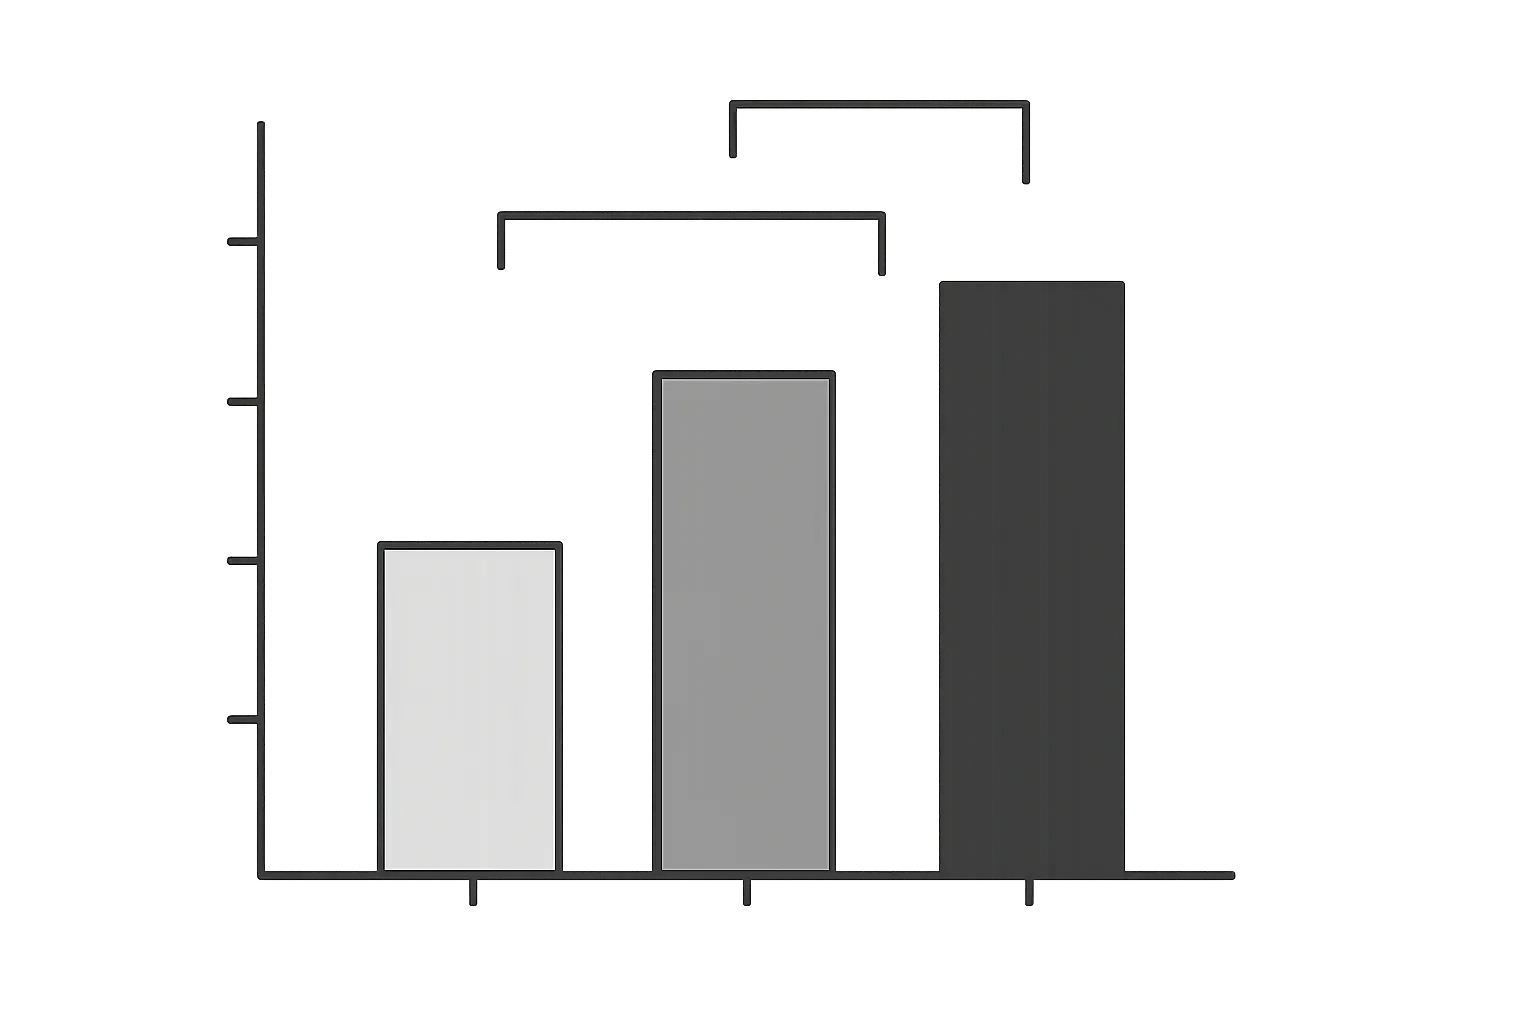
分散分析で有意差が確認された場合、次のステップとして多重比較(post-hoc検定)を行い、どの群とどの群の間に差があるのかを特定する。代表的な方法には次のようなものがある。
- Tukey法(Tukey’s HSD):全ての群の組み合わせを比較する際によく用いられる、比較的保守的な方法。
- Bonferroni法:比較の回数に応じて有意水準を厳しく補正するシンプルな方法。比較数が多いと検出力が下がりやすい。
- Games-Howell法:群ごとの分散が等しくない(等分散性が崩れている)場合に用いられる方法。
なぜ多重比較が必要かというと、分散分析の結果だけでは「差がある」ことは分かっても「どこに差があるか」までは分からないためである。多重比較を省略して個別のt検定を繰り返すと、前述の通り誤って有意差ありと判定する確率が積み上がってしまうため、多重比較の手法を使って有意水準を適切に補正する必要がある。
分散分析を使う前提条件は何か?
分散分析を正しく適用するには、主に次の前提条件を満たしていることが望ましいとされる。
- 正規性:各群のデータが正規分布に近い分布をしていること。Shapiro-Wilk検定などで確認できる。
- 等分散性:各群の分散がおおむね等しいこと。Levene検定やBartlett検定で確認できる。
- 独立性:観測値同士が互いに独立していること(同じ対象を繰り返し測定していないなど)。
これらの前提が大きく崩れている場合は、データを変換してから分散分析を行うか、後述するノンパラメトリック検定への切り替えを検討する。
t検定・ANOVA・ノンパラメトリック検定はどう使い分ける?
| 比較したい群の数 | データが正規分布に近い | データが正規分布から大きく外れる |
|---|---|---|
| 2群 | t検定 | Mann-Whitneyの U検定 |
| 3群以上(要因1つ) | 一元配置分散分析 | Kruskal-Wallis検定 |
| 3群以上(要因2つ) | 二元配置分散分析 | 要因ごとに分割するかノンパラメトリックの代替手法を検討 |
研究デザインの段階で、比較したい群の数とデータの分布特性を確認し、この表を目安に検定を選ぶと分析の手戻りを減らせる。どの研究方法を採用するか自体で迷っている場合は、研究方法の選び方から研究デザイン全体を見直すのも有効である。また、2変数の関連を扱う際に相関関係と因果関係を混同しないための整理は相関分析と回帰分析の違いも参考になる。
よくある質問
Q1. 分散分析と重回帰分析はどう違いますか?
分散分析は主にカテゴリー変数(グループ)ごとの平均値の差を検定する手法であり、重回帰分析は連続変数を含む複数の説明変数から、結果となる変数を予測・説明するための手法である。目的変数が連続量で、説明変数にカテゴリーと連続量が混在する場合は、分散分析ではなく共分散分析(ANCOVA)や重回帰分析が使われることも多い。
Q2. F値が大きければ大きいほど良い結果と言えますか?
F値は群間差の相対的な大きさを示す指標にすぎず、それ単独で「良い結果」とは言えない。p値が有意水準を下回っているかどうかで統計的な有意性を判断したうえで、効果量(例:η²など)を合わせて確認し、差の大きさが実質的に意味を持つかどうかも検討する必要がある。
Q3. 群ごとのサンプルサイズが異なっても分散分析はできますか?
群ごとのサンプルサイズが多少異なっていても分散分析自体は実行できる。ただし群間でサンプルサイズの差が非常に大きい場合、等分散性の前提が崩れていると結果への影響が大きくなりやすいため、Levene検定などで等分散性を確認し、必要に応じてWelchの分散分析など、等分散を仮定しない方法への切り替えを検討するとよい。
Q4. 多重比較を行わずに分散分析の結果だけ報告してもよいですか?
分散分析全体の結果(F値とp値)だけでは「どこかの群に差がある」ことしか示せないため、具体的にどの群間に差があるかを論じたい場合は、Tukey法などの多重比較を追加で行い、その結果も併せて報告するのが一般的な作法である。
Q5. 正規性の前提が崩れている場合はどうすればよいですか?
データの対数変換など、分布の形を正規分布に近づける変換を試す方法と、正規性を仮定しないノンパラメトリック検定(Kruskal-Wallis検定など)に切り替える方法がある。どちらを選ぶかはデータの性質や分野の慣習によって異なるため、指導教員や先行研究の分析方法を参考に判断するとよい。
Q6. 分散分析はExcelでもできますか?
Excelには「分析ツール」というアドインが用意されており、これを有効化すると一元配置分散分析・二元配置分散分析(繰り返しあり・なし)を実行できる。ただし多重比較や効果量の算出は標準機能に含まれていないため、詳細な分析にはRやSPSSなどの統計ソフトを併用するのが一般的である。
{“@context”:”https://schema.org”,”@type”:”FAQPage”,”mainEntity”:[{“@type”:”Question”,”name”:”分散分析と重回帰分析はどう違いますか?”,”acceptedAnswer”:{“@type”:”Answer”,”text”:”分散分析は主にカテゴリー変数(グループ)ごとの平均値の差を検定する手法であり、重回帰分析は連続変数を含む複数の説明変数から、結果となる変数を予測・説明するための手法である。目的変数が連続量で、説明変数にカテゴリーと連続量が混在する場合は、分散分析ではなく共分散分析(ANCOVA)や重回帰分析が使われることも多い。”}},{“@type”:”Question”,”name”:”F値が大きければ大きいほど良い結果と言えますか?”,”acceptedAnswer”:{“@type”:”Answer”,”text”:”F値は群間差の相対的な大きさを示す指標にすぎず、それ単独で「良い結果」とは言えない。p値が有意水準を下回っているかどうかで統計的な有意性を判断したうえで、効果量(例:η²など)を合わせて確認し、差の大きさが実質的に意味を持つかどうかも検討する必要がある。”}},{“@type”:”Question”,”name”:”群ごとのサンプルサイズが異なっても分散分析はできますか?”,”acceptedAnswer”:{“@type”:”Answer”,”text”:”群ごとのサンプルサイズが多少異なっていても分散分析自体は実行できる。ただし群間でサンプルサイズの差が非常に大きい場合、等分散性の前提が崩れていると結果への影響が大きくなりやすいため、Levene検定などで等分散性を確認し、必要に応じてWelchの分散分析など、等分散を仮定しない方法への切り替えを検討するとよい。”}},{“@type”:”Question”,”name”:”多重比較を行わずに分散分析の結果だけ報告してもよいですか?”,”acceptedAnswer”:{“@type”:”Answer”,”text”:”分散分析全体の結果(F値とp値)だけでは「どこかの群に差がある」ことしか示せないため、具体的にどの群間に差があるかを論じたい場合は、Tukey法などの多重比較を追加で行い、その結果も併せて報告するのが一般的な作法である。”}},{“@type”:”Question”,”name”:”正規性の前提が崩れている場合はどうすればよいですか?”,”acceptedAnswer”:{“@type”:”Answer”,”text”:”データの対数変換など、分布の形を正規分布に近づける変換を試す方法と、正規性を仮定しないノンパラメトリック検定(Kruskal-Wallis検定など)に切り替える方法がある。どちらを選ぶかはデータの性質や分野の慣習によって異なるため、指導教員や先行研究の分析方法を参考に判断するとよい。”}},{“@type”:”Question”,”name”:”分散分析はExcelでもできますか?”,”acceptedAnswer”:{“@type”:”Answer”,”text”:”Excelには「分析ツール」というアドインが用意されており、これを有効化すると一元配置分散分析・二元配置分散分析(繰り返しあり・なし)を実行できる。ただし多重比較や効果量の算出は標準機能に含まれていないため、詳細な分析にはRやSPSSなどの統計ソフトを併用するのが一般的である。”}}]}
まとめ
分散分析のやり方は、要因の数に応じて一元配置と二元配置を使い分け、F値とp値で全体の有意差を確認したうえで、必要に応じて多重比較で差の所在を特定する、という流れで整理できる。正規性・等分散性・独立性の前提条件を確認しながら進めることで、卒業論文や修士論文における統計分析の説得力を高められる。