クロンバックのα係数の求め方2026|尺度の信頼性を確認する手順とExcel・統計ソフトでの算出
自作の質問紙や尺度を論文で使う際、指導教員から「クロンバックのα係数を報告してください」と言われた経験はないだろうか。α係数は量的研究で最も広く使われる内的整合性の指標であり、卒論・修論の方法論セクションで報告が求められる場面は多い。しかし「求め方がよくわからない」「0.7という基準の意味がよくわからない」「SPSSとExcelで結果が違う気がする」と戸惑う学生も少なくない。
この記事では、クロンバックのα係数の求め方を数式の意味から始め、各統計ソフト(Excel・jamovi・SPSS)での具体的な算出手順、結果の記述例、そしてよくある誤解まで、研究方法論の視点から体系的に解説する。尺度の設計段階から分析・報告まで、一連の流れを把握することが目的だ。
なお、本記事で示す数値例は説明用のものであり、実際の研究データに基づくものではない。数式・基準値は心理測定論における標準的な定義に従っている。
α係数は、複数の項目が同じ構成概念を測定しているかを示す内的整合性の指標。公式は α = (k/(k−1)) × (1 − ΣVᵢ/Vₓ) で、k は項目数、ΣVᵢ は各項目の分散の合計、Vₓ は合計得点の分散。一般的な合格ラインはα ≥ 0.70。Excel では手動で算出、jamovi・SPSS では専用メニューから数ステップで算出できる。
クロンバックのα係数とは
クロンバックのα係数(Cronbach’s alpha、以下 α 係数)は、1951年にリー・クロンバック(Lee J. Cronbach)が提唱した、心理尺度・質問紙の内的整合性(internal consistency)を評価する指標だ。
「内的整合性」とは、尺度を構成する複数の質問項目が互いにどの程度一貫した方向を測定しているかを指す。たとえば「職場のストレス」を5項目で測る尺度があるとして、回答者が1項目で高い値を示すなら、他の項目でも同様に高い値を示す傾向があるか、というコヒーレンスの度合いだ。
信頼性の種類とα係数の位置づけ
測定の信頼性には複数の種類がある。
| 種類 | 内容 | 確認方法 |
|---|---|---|
| 内的整合性 | 同一時点での項目間の一貫性 | クロンバックα・ωなど |
| 再検査信頼性 | 異なる時点での測定の一貫性 | 相関係数(2時点) |
| 評定者間信頼性 | 複数評定者の一致度 | ICC・κ係数 |
質問紙調査で自作尺度を使う量的研究では、原則として内的整合性の報告が求められ、α係数が最も一般的に用いられる。研究用アンケートの尺度設計の段階でリッカート形式を採用した場合は、特にα係数の確認が不可欠だ。
計算の仕組みと数式
α係数の公式は次のとおりだ。
- k:尺度を構成する項目数
- ΣVᵢ:各項目の分散の合計(項目ごとの散らばり)
- Vₓ:全項目の合計得点の分散(尺度全体の散らばり)
式の直感的な意味
ΣVᵢ / Vₓ の比は、「各項目の散らばりの合計が、全体の散らばりのうち何割を占めるか」を表す。もし全項目が完全に相関していれば、合計得点の分散は各項目の共分散(共通部分)で構成され、この比は小さくなる。その結果 (1 − ΣVᵢ / Vₓ) が1に近づき、α も1に近づく。逆に項目間の相関がほとんどなければ合計分散 Vₓ は小さくなる(分散の加算が相殺し合わない)ため、比は大きくなり α は低くなる。
この構造から α は 0 以上 1 以下の値を取り(理論上は負にもなり得るが稀)、1 に近いほど内的整合性が高いことを意味する。
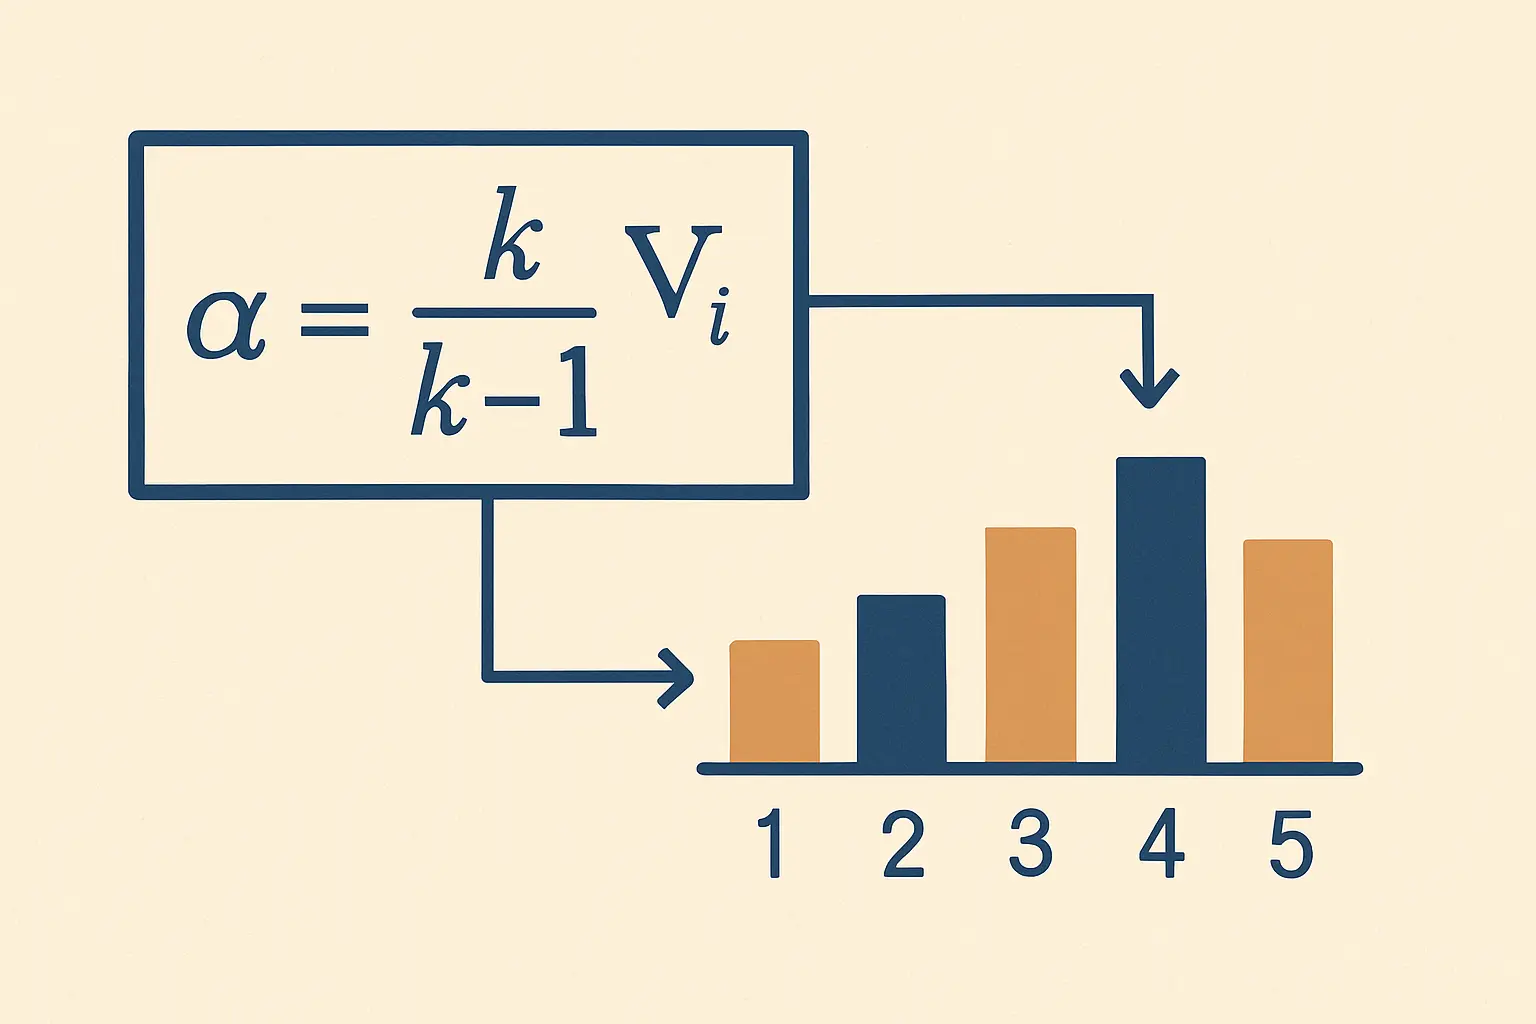
α係数の解釈基準と注意点
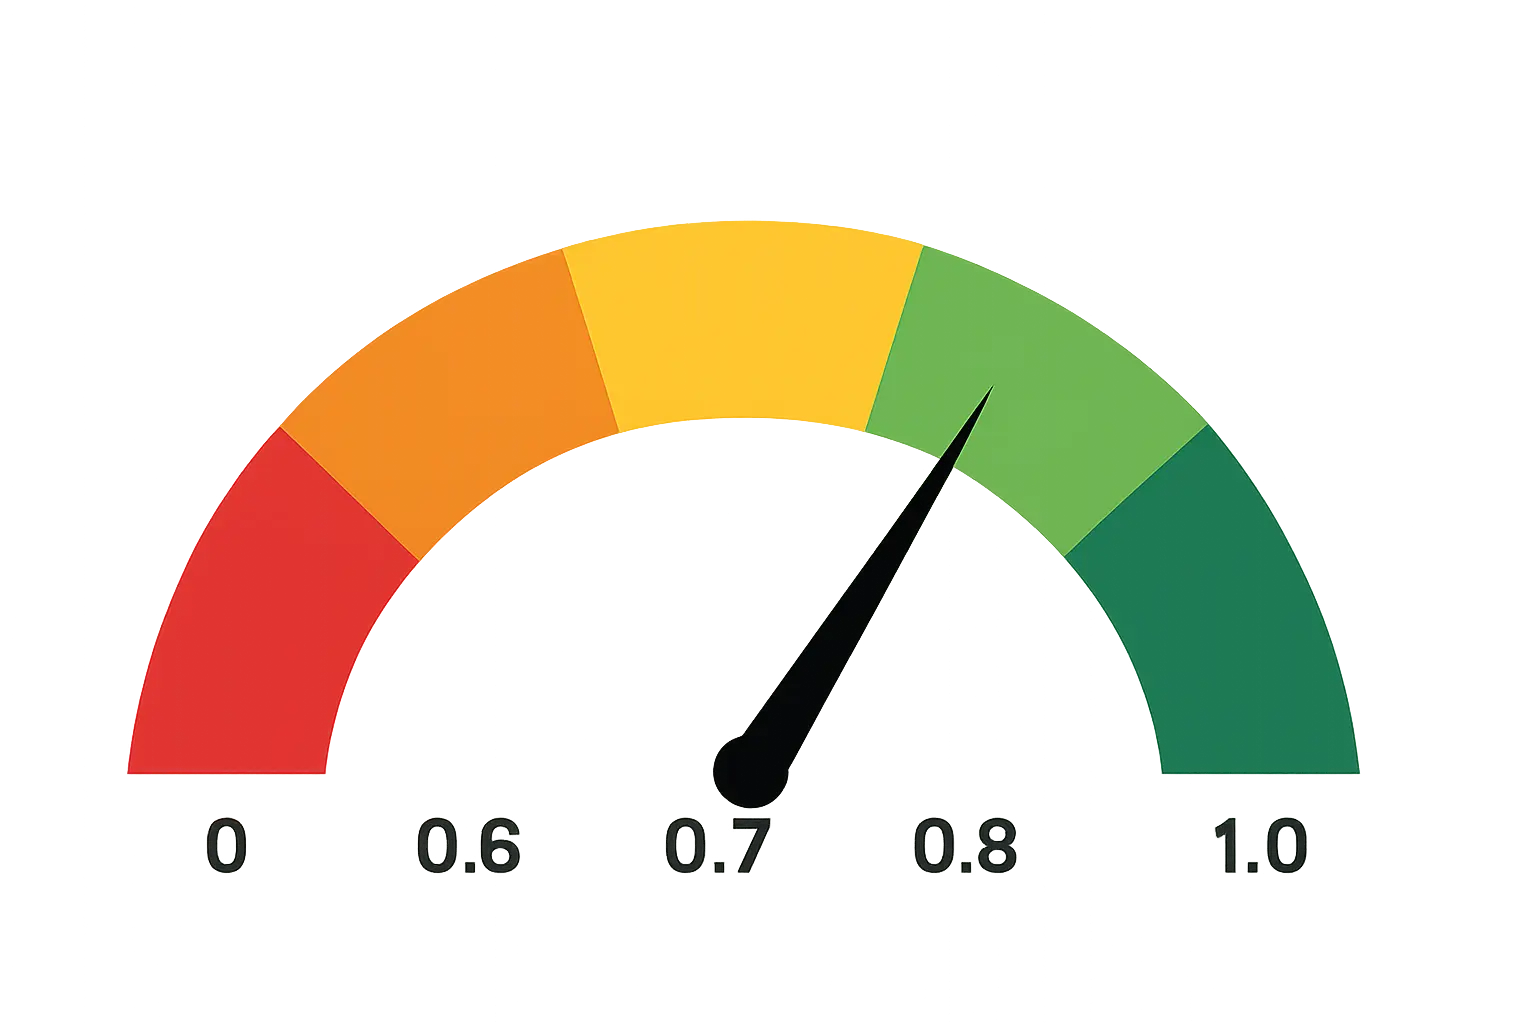
α係数の解釈に関しては、複数の研究者が段階的な基準を提示している。以下は心理測定論の教科書で広く参照される目安だ(あくまで一般的な指針であり、研究分野や尺度の用途によって判断は異なる)。
| α値の範囲 | 評価 | 対応の目安 |
|---|---|---|
| α ≥ 0.90 | 優秀(Excellent) | 項目数が多すぎる可能性も確認 |
| 0.80 ≤ α < 0.90 | 良好(Good) | 概ね問題なし |
| 0.70 ≤ α < 0.80 | 許容可(Acceptable) | 多くの社会科学研究で最低ライン |
| 0.60 ≤ α < 0.70 | 疑問あり(Questionable) | 項目の見直しを検討 |
| α < 0.60 | 低い(Poor) | 尺度の再設計が必要 |
「0.7以上」という基準の根拠と注意
α ≥ 0.70 という基準は、Nunnally(1978)の著書 Psychometric Theory で示された目安として広く引用されている。ただしNunnally自身も、研究の段階(予備的研究 vs. 高リスク意思決定)によって求められる水準が異なると述べており、「0.7 を下回ったら自動的にNG」という単純な使い方は適切ではない。
項目削除時のαを活用する
α係数の分析では「その項目を削除した場合のα(Cronbach’s Alpha if Item Deleted)」と「修正済み項目合計相関(Corrected Item-Total Correlation)」が同時に出力される。これらは尺度の改善に直接使える。
修正済み項目合計相関(CITC)の見方
CITCは、ある1項目と、その項目を除いた残りの合計得点との相関係数を示す。一般的に CITC < 0.30 の項目は、尺度全体との関連が弱く、削除候補となる。
「項目削除時のα」の活用手順
- CITC が 0.30 未満の項目を特定する
- 「その項目を削除した場合のα」が現在のαより大幅に上昇する場合は削除を検討
- 削除には理論的根拠も必要:数値だけでなく、その項目が構成概念から外れていないか概念的に確認する
- 削除後は再度α係数を算出し、最終的な項目セットで報告する
この項目の選別プロセスは、量的研究の方法論設計における尺度開発の一部として文書化し、方法論セクションに記載することが望ましい。
Excelでの算出手順
ExcelにはCronbach’s αを一発で算出する関数がない。そのため、公式に従って手動で計算する必要がある。以下は5項目(Q1〜Q5)、回答者数 N の場合の手順だ(以下のセル参照は説明用の例示であり、実際のデータ配置に合わせて変更すること)。
- データを入力する:列A〜Eに各項目(Q1〜Q5)の回答データを入力(1行目を変数名、2行目以降をデータとする)
- 合計得点列を作成する:列Fに各回答者の合計得点を入力。例:
=SUM(A2:E2)を各行に展開 - 各項目の分散を算出する:別セルに
=VAR.S(A2:A101)(N=100の場合)をQ1〜Q5分それぞれ算出 - 分散の合計(ΣVᵢ)を求める:上記5つの分散の合計を計算
- 合計得点の分散(Vₓ)を求める:
=VAR.S(F2:F101) - α係数を計算する:
=(5/(5-1))*(1-(ΣVᵢのセル/Vₓのセル))
Excelでのクロス集計と組み合わせてデータの全体像を把握したい場合は、Excelのピボットテーブルによるクロス集計の手順も参照されたい。
VAR.S は不偏分散(サンプル分散、n−1 で割る)を返す。SPSS や jamovi も同じ不偏分散を使用するため、手計算と統計ソフトの結果は一致するはずだ。VAR.P(母分散)との混同に注意。
jamovi・SPSSでの算出手順
jamoviでの手順
jamovi は無料のオープンソース統計ソフトであり、インターフェースが直感的で卒論・修論での利用が増えている。
- データを読み込む(CSV・Excelいずれも可)
- メニューから 「Analyses(分析)」→「Factor(因子)」→「Reliability Analysis(信頼性分析)」 を選択
- 分析対象の項目を「Items」ボックスに移動
- 「Scale Statistics」で Cronbach’s α にチェックを入れる
- 「Item Statistics」で Cronbach’s α(if item dropped) と Item-rest correlation にチェックを入れると、項目削除時の情報も取得できる
- 結果が右ペインに即時表示される
SPSSでの手順
SPSS は多くの大学で利用可能な商用統計ソフトだ。
- データを読み込み、変数ビューで各項目の変数タイプを確認する
- メニューから 「分析」→「尺度」→「信頼性分析」 を選択
- 分析対象の項目を「項目」ボックスに移動
- 「モデル」で 「α」 が選択されていることを確認
- 「統計」ボタンをクリックし、「項目が削除された場合の尺度」 にチェックを入れる
- 「OK」をクリックすると出力ウィンドウに結果が表示される
出力の「信頼性統計量」テーブルに α 係数と項目数が、「項目合計統計量」テーブルに各項目の CITC と「項目が削除された場合のCronbach’s α」が表示される。
結果の記述例
論文の方法論セクションにα係数を記載する際は、値・項目数・解釈根拠をセットで記述する。以下は記述例だ(数値は説明用の例示)。
「職場ストレス尺度(5項目)の内的整合性を確認したところ、クロンバックのα係数は α = .83 であり、許容できる水準(Nunnally, 1978)を上回っていた。修正済み項目合計相関はいずれも .40 以上であり、各項目が尺度全体と十分な関連を有していることが確認された。」
APAスタイルでは、0 の前のゼロを省略して「.83」と表記するのが慣例だ。また、研究計画書の段階から信頼性確認の手順を設計に盛り込んでおくことで、後の分析がスムーズになる。研究計画書の書き方では方法論セクションの構成テンプレートも紹介している。
よくある誤解
誤解1:αが高ければ単一次元(一次元性)が保証される
α係数は内的整合性を測るが、一次元性(unidimensionality)を直接証明するものではない。互いに相関していれば複数の下位次元を含む尺度でも α は高くなりうる。一次元性の検討には探索的因子分析(EFA)や確認的因子分析(CFA)が必要だ。
誤解2:αは「信頼性そのもの」の完全な指標
α は真のスコアの分散と観測分散の比(信頼性の下限)を推定するが、測定の全側面を捉えるわけではない。近年はより堅牢な指標としてマクドナルドのω(McDonald’s omega)も用いられるため、分野の慣習に応じて使い分けることが望ましい。
誤解3:逆転項目の処理を忘れる
ネガティブに表現された逆転項目(例:「私はほとんど楽しくない」)を含む尺度では、α算出前に逆転処理(リコーディング)が必須だ。逆転処理なしに算出すると α が著しく低下し、本来の内的整合性を正しく反映しない。
誤解4:α ≥ 0.70 なら尺度として問題ない
基準値を満たすことは必要条件の一つに過ぎない。妥当性(測りたいものを測れているか)・因子構造・項目の内容妥当性など、総合的な評価が不可欠だ。
よくある質問(FAQ)
クロンバックのαとピアソン相関係数はどう違いますか?
ピアソン相関係数は2変数間の線形関係の強さを示すのに対し、クロンバックのα係数は3項目以上から構成される尺度全体の内的整合性を評価する。2項目の尺度では α はピアソン相関係数の関数になるため、通常はα係数を使わずに相関係数を報告する。
α係数が0.7を下回った場合、論文は提出できませんか?
0.7 という基準は絶対的な規則ではなく、研究分野・研究段階・尺度の用途によって判断が異なる。予備的研究や多次元構成概念の部分尺度では 0.60 台でも認められることがある。低い場合は、理由(項目数の少なさ、構成概念の複雑さ等)を方法論セクションで説明し、限界点として議論することが求められる。
項目を増やせばα係数は必ず上がりますか?
同じ構成概念を測定する類似した項目を追加すれば、α係数は上昇する傾向がある(スピアマン・ブラウン公式の原理による)。しかし無関連な項目を追加すれば α は下がる可能性があり、また冗長な項目を増やすことで回答者の負担が増し、調査の質が低下するリスクもある。項目数の増加だけで α を「操作」することは避けるべきだ。
サンプルサイズはα係数の算出に影響しますか?
α係数の点推定値自体はサンプルサイズで大きく変わらないが、推定の安定性(標準誤差)はサンプルサイズに依存する。N が小さいほど推定値の変動が大きくなるため、可能であれば信頼区間(CI)とともに報告することが推奨される。一般的な目安として、N ≥ 100 前後が望ましいとされる(ただし研究の文脈による)。
下位尺度ごとにαを報告すべきですか?
尺度が複数の下位尺度(サブスケール)で構成される場合、全体のα係数だけでなく、各下位尺度についても個別にα係数を報告することが望ましい。全体のαが高くても下位尺度のαが低い場合は、その下位尺度の使用に注意が必要だと方法論セクションで述べる。
尺度開発から論文執筆まで、AIでサポート
信頼性分析の結果を方法論セクションに正確に記述したい、アンケート設計から考察まで一貫した支援が欲しいという場合は、論文AIツールの Tesify が参考になるかもしれない。研究手順の整理や文章の構成に活用できる。