生成AIに研究データを入力してよいか2026|逐語録・個人情報・機密データの線引き
「AIを使って書いてよいか」と「AIにデータを渡してよいか」は別の問題である。前者は大学の利用ルールの話だが、後者は個人情報の取扱いと、倫理審査で対象者に約束した内容の話になる。要約させたい逐語録に氏名が残っているなら、書いてよいかを考える前に止まる必要がある。
結論を先に言うと:識別情報を含むデータは、匿名化してから入力する。倫理審査で「研究者のみが取り扱う」と説明していた場合は、外部サービスへの入力がその説明と食い違わないかを先に確認する。所属機関が契約している環境があるなら、個人の無料アカウントではなくそちらを使う。
「使ってよいか」とは別の問題である
生成AIをめぐる学生の疑問は、実際には二層に分かれている。
- 第一層:執筆にAIを使ってよいか——大学・科目のルールと、成果物の著者性の問題
- 第二層:AIにデータを渡してよいか——個人情報の取扱いと、対象者への説明責任の問題
第一層については大学のAI利用ルールはどうなってる?と論文でのAI利用を正しく明記する方法で扱っている。本記事は第二層に絞る。
この区別が重要なのは、第一層で許可されていても第二層では許されない場合があるからだ。「構成の相談にAIを使ってよい」という科目のルールは、「インタビュー対象者の発言をAIに送ってよい」という意味を含まない。
個人情報の観点ではどう考えるのか?
判断の枠組みとして参考になるのが、個人情報保護委員会の「個人情報の保護に関する法律についてのガイドライン」に関するQ&Aにあるクラウドサービスの扱いである。同Q&Aでは、クラウドサービスの利用が第三者提供に当たるかどうかは、クラウドに個人データが保存されるかどうかではなく、サービス提供事業者がその個人データを取り扱うこととなっているかどうかで判断されるとされている。取り扱わないこととなっている場合には第三者提供に当たらず、本人の同意は不要とされる。
この考え方を生成AIに当てはめると、可否がサービスの契約内容と設定に依存することが分かる。入力内容が事業者側で利用される前提のサービスと、事業者が内容を取り扱わないことが契約で担保されている環境とでは、置かれた状況が異なる。
ここで断っておきたいのは、本記事は一般的な考え方の整理であり、個別の事案についての法的助言ではないという点である。研究で扱うデータの性質は分野によって大きく異なるため、判断に迷う場合は所属機関の窓口に確認してほしい。
倫理審査で約束した範囲との関係
法令とは別に、学生の研究で実際に効いてくるのが同意説明文書に何と書いたかである。倫理審査を経た研究では、対象者に対してデータの取扱いを説明し、その範囲で同意を得ている。
典型的な文言は次のようなものである。
- 「データは研究者が管理するパソコンに保管し、研究者のみが取り扱います」
- 「データは本研究の目的以外には使用しません」
- 「個人が特定される情報は削除したうえで分析します」
1つ目のように書いていた場合、外部のAIサービスへ逐語録を送る行為は、説明した取扱いと食い違う可能性がある。法的にどう評価されるか以前に、対象者への説明と異なる扱いをしたという事実が研究倫理上の問題になる。
逆に言えば、AIの利用を見込んでいるなら、同意取得の段階でその旨を説明に含めておけばよい。同意説明文書の作り方はインフォームドコンセントの書き方にまとめている。後から範囲を広げるより、最初から書いておくほうがはるかに簡単である。
何を入力してよいのか?
データの性質ごとに整理すると判断しやすい。
| データ | 入力の判断 | 理由 |
|---|---|---|
| 自分が書いた本文の草稿 | 問題になりにくい | 自分の著作であり第三者の情報を含まない |
| 公開されている統計・論文の記述 | 問題になりにくい | すでに公表されている情報 |
| 匿名化済みの分析用データ | 条件付きで可 | 同意の範囲と利用環境の確認が要る |
| インタビュー逐語録(生データ) | 避ける | 氏名・勤務先などが残っていることが多い |
| 実習記録・症例の記述 | 避ける | 要配慮個人情報を含みうる |
| 勤務先の未公表データ | 避ける | 守秘義務の対象 |
| 共同研究先から提供されたデータ | 避ける | 提供元との取り決めが優先する |
下4行に共通するのは、自分だけの判断で扱いを決められないデータだという点である。対象者、勤務先、提供元といった他者の利益が絡む場合、自分が便利だと思うかどうかは判断基準にならない。
録音データを文字起こしサービスに渡す場合も同じ検討が要る。音声には話者の声に加え、会話中に出てくる固有名詞が含まれる。ツールごとの特性は研究インタビューの文字起こしAI比較で扱っているが、選定の前に取扱い方針を確認したい。逐語録そのものの作り方は半構造化インタビューのやり方を参照してほしい。
匿名化はどこまでやるのか?
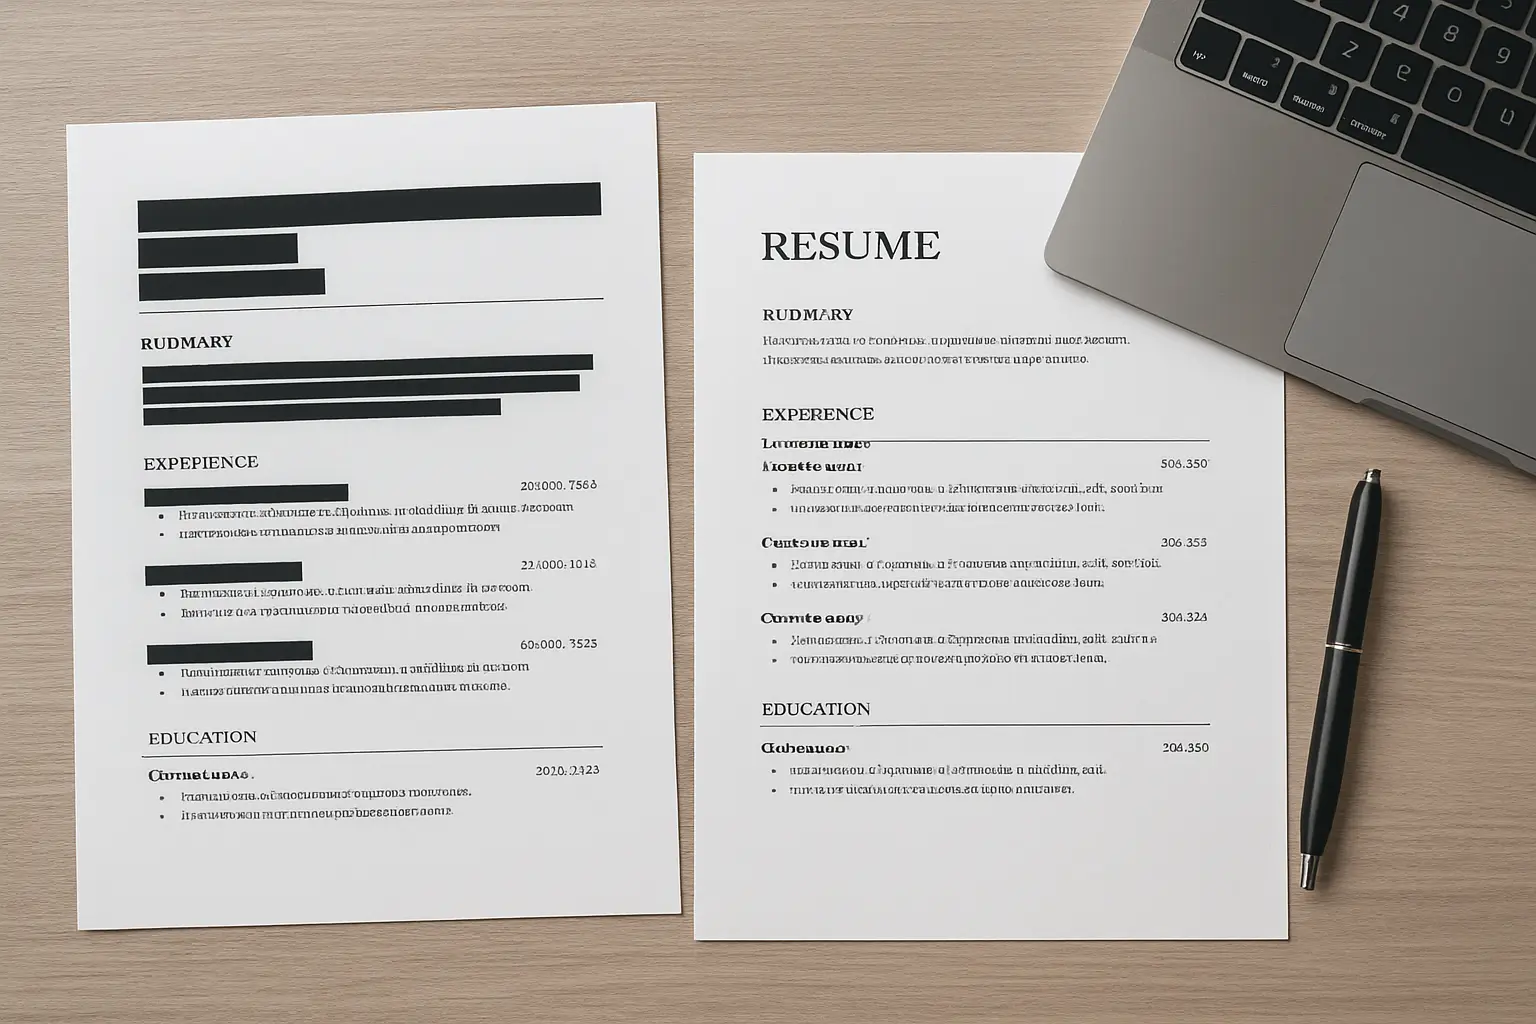
「氏名を伏せたから大丈夫」は危うい。次まで処理して初めて、実務上の匿名化と言える。
- 直接識別子を置換する——氏名、学籍番号、連絡先を記号に置き換える
- 準識別子をぼかす——所属、役職、年齢、地域は粒度を落とす
- 組み合わせを点検する——「県内で唯一の」「創業○年の」のような記述は単独で特定につながる
- 固有名詞を確認する——会話中に出てくる第三者の名前も対象になる
- 対応表を分離保管する——記号と実名の対応表は入力するデータと別に管理する
3番目が最も見落とされる。小さな組織や希少な属性を扱う研究では、氏名を消しても文脈から一人に絞り込めてしまう。データの保管方法そのものについては研究データの保存・管理ルールにまとめている。
設定と環境で何が変わるのか?
同じサービスでも、使い方によってリスクは変わる。最低限、次を確認しておきたい。
- 学習利用の設定——入力内容がモデルの改善に使われる設定になっていないか
- 所属機関の契約環境——大学が契約している環境があれば、個人の無料アカウントより望ましい
- 保存期間と削除——履歴がどれだけ残り、削除できるか
- アカウントの共有——研究室で共有しているアカウントに他人のデータを残さない
- 大学のガイドライン——入力してはいけない情報の類型が示されていることがある
学習利用をオフにすることは有効だが、それだけで安全になるわけではない。データがどこに保存され、誰がアクセスしうるかという点も併せて確認する必要がある。所属機関が用意した環境があるなら、それを使うのが最も確実である。
データを渡さずに進められる作業から片付ける
Tesifyは、章立ての整理、引用・参考文献の書式統一、独自性の自己点検を支援するAIツールです。対象者のデータを渡さなくても進められる工程は少なくありません。どのツールを使う場合も、所属大学の規定と倫理審査で承認された取扱いの範囲を先に確認してください。
よくある質問
インタビューの逐語録を生成AIに貼って要約させてよいですか?
そのまま貼るのは避けてください。逐語録には氏名や勤務先など個人を特定できる情報が残っていることが多く、倫理審査で約束した取扱いの範囲を超える恐れがあります。氏名や地名を記号に置き換えるなど匿名化してから使うのが前提です。
AIに入力すると個人情報の第三者提供になりますか?
個人情報保護委員会のガイドラインQ&Aでは、クラウドサービスの利用が第三者提供に当たるかは、サービス提供事業者がその個人データを取り扱うかどうかで判断されるとされています。したがってサービスの契約内容と設定次第で結論が変わるため、一律に可否を決めることはできません。
倫理審査を通っていればAIに入力してよいのですか?
承認された計画書と同意説明文書に書いた取扱いの範囲によります。「研究者のみが取り扱う」と説明していた場合、外部サービスへの入力はその説明と食い違う可能性があります。判断に迷う場合は倫理審査委員会か指導教員に確認してください。
匿名化すればどんなデータでも入力してよいですか?
氏名を消しただけでは不十分な場合があります。所属、役職、時期、地域などの組み合わせから個人が特定されることがあるため、記述の粒度まで含めて確認してください。企業の未公表データなど、個人情報とは別に守秘義務の対象となる情報にも注意が必要です。
学習に使われない設定にすれば問題ありませんか?
学習利用をオフにすることはリスクを下げますが、それだけで安全とは言えません。データがどこに保存され、誰がアクセスしうるかという点も併せて確認する必要があります。所属機関が契約している環境が用意されているなら、そちらを使うのが確実です。
文字起こしAIに録音データを渡すのはどうですか?
音声には話者の声そのものに加え、会話中の固有名詞が含まれます。逐語録をテキストで渡す場合と同じ検討が必要です。利用するサービスの取扱い方針を確認し、可能なら同意取得の段階で文字起こしサービスの利用を説明に含めておくと後の判断が楽になります。
{“@context”:”https://schema.org”,”@type”:”FAQPage”,”mainEntity”:[{“@type”:”Question”,”name”:”インタビューの逐語録を生成AIに貼って要約させてよいですか?”,”acceptedAnswer”:{“@type”:”Answer”,”text”:”そのまま貼るのは避けてください。逐語録には氏名や勤務先など個人を特定できる情報が残っていることが多く、倫理審査で約束した取扱いの範囲を超える恐れがあります。氏名や地名を記号に置き換えるなど匿名化してから使うのが前提です。”}},{“@type”:”Question”,”name”:”AIに入力すると個人情報の第三者提供になりますか?”,”acceptedAnswer”:{“@type”:”Answer”,”text”:”個人情報保護委員会のガイドラインQ&Aでは、クラウドサービスの利用が第三者提供に当たるかは、サービス提供事業者がその個人データを取り扱うかどうかで判断されるとされています。したがってサービスの契約内容と設定次第で結論が変わるため、一律に可否を決めることはできません。”}},{“@type”:”Question”,”name”:”倫理審査を通っていればAIに入力してよいのですか?”,”acceptedAnswer”:{“@type”:”Answer”,”text”:”承認された計画書と同意説明文書に書いた取扱いの範囲によります。「研究者のみが取り扱う」と説明していた場合、外部サービスへの入力はその説明と食い違う可能性があります。判断に迷う場合は倫理審査委員会か指導教員に確認してください。”}},{“@type”:”Question”,”name”:”匿名化すればどんなデータでも入力してよいですか?”,”acceptedAnswer”:{“@type”:”Answer”,”text”:”氏名を消しただけでは不十分な場合があります。所属、役職、時期、地域などの組み合わせから個人が特定されることがあるため、記述の粒度まで含めて確認してください。企業の未公表データなど、個人情報とは別に守秘義務の対象となる情報にも注意が必要です。”}},{“@type”:”Question”,”name”:”学習に使われない設定にすれば問題ありませんか?”,”acceptedAnswer”:{“@type”:”Answer”,”text”:”学習利用をオフにすることはリスクを下げますが、それだけで安全とは言えません。データがどこに保存され、誰がアクセスしうるかという点も併せて確認する必要があります。所属機関が契約している環境が用意されているなら、そちらを使うのが確実です。”}},{“@type”:”Question”,”name”:”文字起こしAIに録音データを渡すのはどうですか?”,”acceptedAnswer”:{“@type”:”Answer”,”text”:”音声には話者の声そのものに加え、会話中の固有名詞が含まれます。逐語録をテキストで渡す場合と同じ検討が必要です。利用するサービスの取扱い方針を確認し、可能なら同意取得の段階で文字起こしサービスの利用を説明に含めておくと後の判断が楽になります。”}}]}