カイ二乗検定とは、カテゴリカルデータのクロス集計表において、2つの変数が独立かどうかを度数の偏りから判定する検定である。
「学部によってAI利用の有無に差があるか」「性別と志望進路に関連があるか」のように、量ではなく個数を数えたデータを扱うときに使う。t検定や分散分析が平均値を比べるのに対し、カイ二乗検定は度数の分布を比べる点が根本的に違う。
独立性の検定と適合度検定はどう違うのか?
| 種類 | 問い | データの形 | 自由度 |
|---|---|---|---|
| 独立性の検定 | 2変数に関連があるか | 行×列のクロス集計表 | (行数−1)×(列数−1) |
| 適合度検定 | 観測分布が理論分布に合うか | 1変数の度数分布 | カテゴリ数−1 |
卒論で使うのはほぼ独立性の検定だ。2×2表(各変数が2カテゴリ)なら自由度は1、3×4表なら自由度は6になる。どの検定を選ぶべきか迷う場合は統計手法の選び方フローチャートで全体像を確認してほしい。
カイ二乗検定の5ステップ
ステップ1:クロス集計表を作る
行と列に変数を配置し、各セルに実測度数(観測された人数)を入れる。ここで入れるのは必ず度数(人数)であって、パーセントではない。割合を入力してしまうのは最頻出のミスだ。Excelでの作表はピボットテーブルでクロス集計表を作るやり方が速い。
ステップ2:期待度数を計算する
各セルの期待度数は次の式で求める。
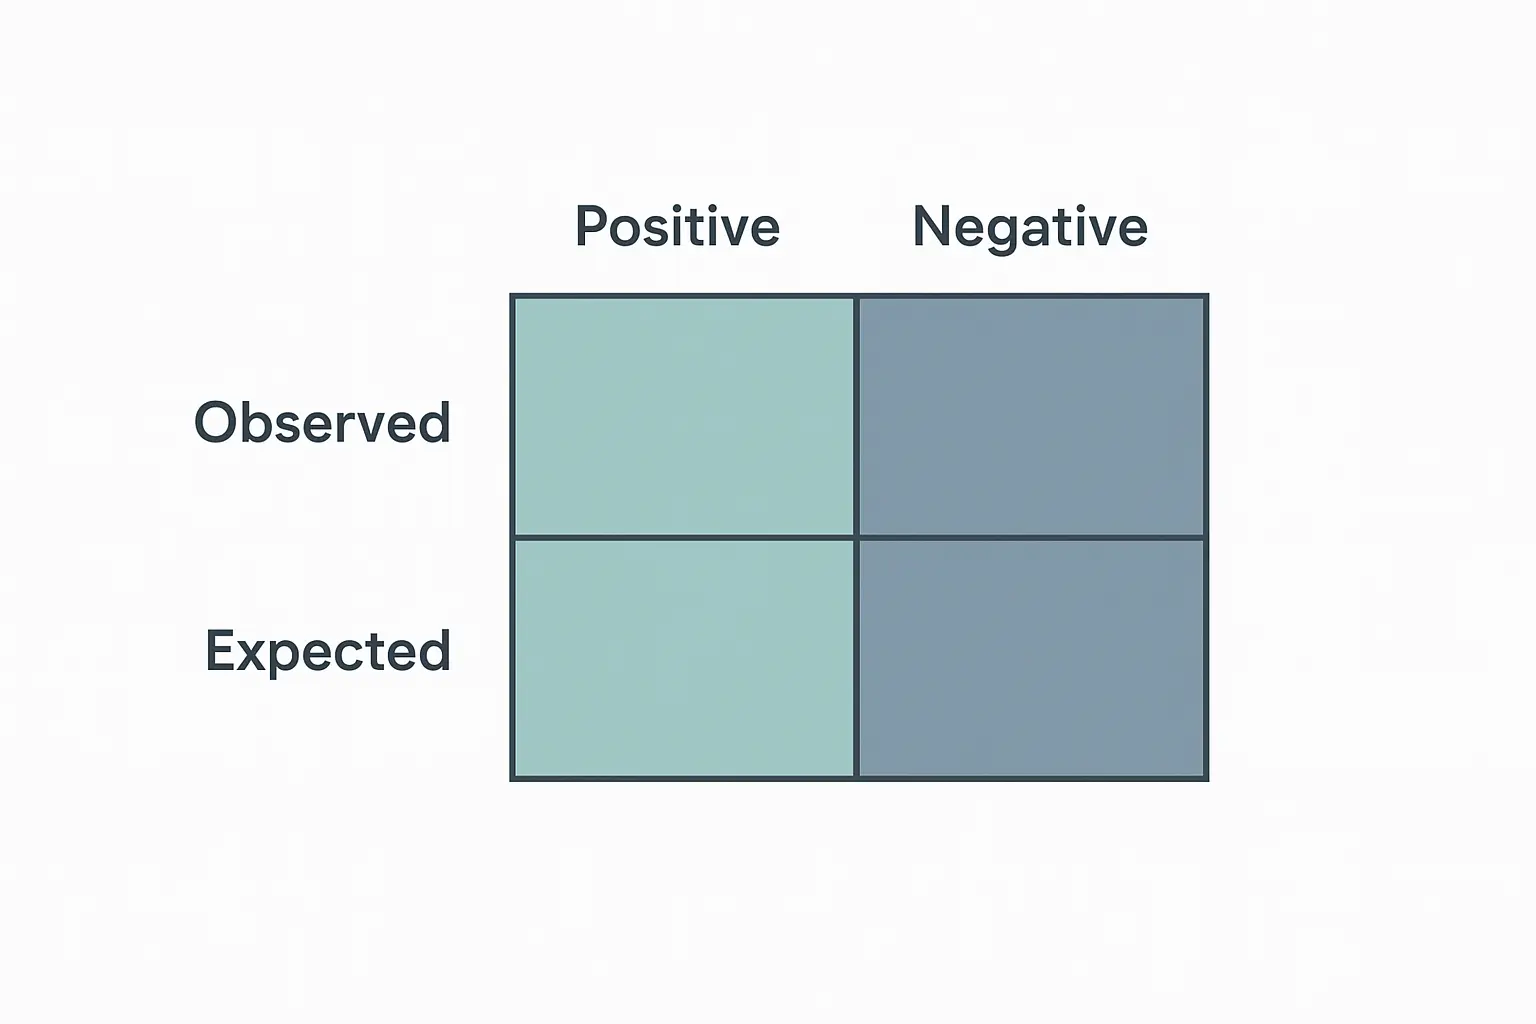
期待度数 =(その行の合計 × その列の合計)÷ 全体の合計
「2変数が完全に独立だったら、このセルには何人入るはずか」という値だ。統計ソフトなら自動で出るが、手計算でも数分で終わる。
ステップ3:期待度数の前提を確認する
ここが実務上の最大の関門になる。カイ二乗検定には期待度数に関する前提条件がある。
- 期待度数が5未満のセルが全体の20%以下であること
- 期待度数が1未満のセルが1つもないこと
2×2表では全4セルの期待度数がすべて5以上であることが望ましい。この前提を満たさない場合、カイ二乗値は信頼できない。Fisherの正確確率検定に切り替える(2×2表なら統計ソフトの標準機能で実行できる)。3×4表などで前提を満たさない場合は、意味の近いカテゴリを統合して表を小さくするのが現実的な対処だ。
ステップ4:カイ二乗値とp値を求める
カイ二乗値は、各セルについて(実測度数−期待度数)²÷期待度数 を計算し、全セルを合計した値である。Excelなら CHISQ.TEST(実測範囲, 期待範囲) でp値が直接得られる。SPSSなら[分析]→[記述統計]→[クロス集計表]→[統計量]で「カイ2乗」にチェックを入れる。Rでは chisq.test(table) で実行できる。
ステップ5:効果量を報告する
p値だけでは「差があるか」しか分からない。どのくらい強い関連かを示すには効果量が必要だ。カイ二乗検定では次を使う。
| 指標 | 使う場面 | 小 | 中 | 大 |
|---|---|---|---|---|
| φ係数(ファイ) | 2×2表 | 0.10 | 0.30 | 0.50 |
| クラメールのV | それ以上の表 | 0.10 | 0.30 | 0.50 |
基準はCohenの慣行的な目安に基づく。自由度が大きい表ではVの解釈が変わるため、分野の先行研究がどの水準を「関連あり」としているかも併せて確認したい。
結果の書き方
論文本文には、カイ二乗値・自由度・標本数・p値・効果量を1文にまとめて書く。APA形式なら次の型になる。
学部と生成AIの利用経験の関連を検討するため、カイ二乗検定を行った。その結果、両者の間に有意な関連が認められた(χ²(1, N = 240) = 8.42, p = .004, φ = .19)。文系学部の利用率(68.3%)は理系学部(51.2%)より高かった。
有意でなかった場合も、同じ形式で数値を報告する。「関連は認められなかった(χ²(1, N = 240) = 1.87, p = .172, φ = .09)」のように書き、検出力の問題を限界として述べるのが誠実な処理だ。
よくある失敗
- 同一人物を複数セルに数える——カイ二乗検定は各観測が独立であることを前提とする。複数回答可の設問をそのままクロス集計にかけてはいけない。
- 順序尺度の情報を捨てる——「非常に不満/不満/満足/非常に満足」のような順序をカイ二乗検定にかけると、順序の情報が失われる。傾向を見たいならMantel-Haenszelの傾向検定などを検討する。
- 標本が大きすぎて何でも有意になる——N が数千あると、実質的に無視できる差でもp < .05 になる。だからこそ効果量の報告が要る。
- 設問設計の段階でカテゴリが細かすぎる——期待度数不足はほぼ設問設計に起因する。研究用アンケートの作り方の段階でカテゴリ数を抑えておく。
よくある質問
Yatesの連続性補正は使うべきですか?
2×2表で標本が小さい場合に用いられてきましたが、補正が保守的すぎるという指摘があります。近年はFisherの正確確率検定を使うか、補正なしの値と併記する扱いが増えています。分野の慣行に合わせてください。
期待度数が5未満のセルが1つだけあります。実行してよいですか?
2×2表では避けてください。行数・列数が大きい表であれば、5未満のセルが全体の20%以下に収まっているかを確認し、収まっていれば実行できます。
t検定とカイ二乗検定はどう使い分けますか?
従属変数が量的変数(点数、時間など)ならt検定、カテゴリ(あり/なし、所属など)ならカイ二乗検定です。3群以上の平均比較は分散分析(ANOVA)を使います。
有意になったあと、どのセルが効いているか調べられますか?
調整済み標準化残差を見ます。絶対値がおおむね2以上のセルが、独立を仮定した場合の期待から大きく外れている箇所です。SPSSでは[セル]オプションで出力できます。
Excelだけで効果量まで出せますか?
出せます。クラメールのVは、カイ二乗値÷(全体度数×min(行数−1, 列数−1))の平方根で計算できるため、CHISQ.TEST で得たp値とは別に CHISQ.INV.RT などを組み合わせてカイ二乗値を求め、手計算で算出してください。